5-bit K-quantized block structure (ggml's block_q5_K) More...
#include <quantization.h>
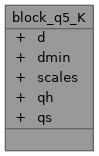
Public Attributes | |
| uint16_t | d |
| uint16_t | dmin |
| uint8_t | scales [12] |
| uint8_t | qh [GGML_QK_K/8] |
| uint8_t | qs [GGML_QK_K/2] |
Detailed Description
5-bit K-quantized block structure (ggml's block_q5_K)
Q4_K's super-block scale, minimum and packed 6-bit sub-block scales, plus one high bit per weight: element l of 32-element sub-block s is d * sc[s] * ((qs[32 * (s / 2) + l] >> 4 * (s % 2) & 15) | ((qh[l] >> s & 1) << 4)) - dmin * m[s].
Definition at line 73 of file quantization.h.
Member Data Documentation
◆ d
| uint16_t block_q5_K::d |
Super-block scale (f16)
Definition at line 74 of file quantization.h.
◆ dmin
| uint16_t block_q5_K::dmin |
Super-block minimum scale (f16)
Definition at line 75 of file quantization.h.
◆ qh
High (fifth) bit of each weight
Definition at line 77 of file quantization.h.
◆ qs
Low four bits of each weight
Definition at line 78 of file quantization.h.
◆ scales
| uint8_t block_q5_K::scales[12] |
Sub-block scales and minimums, 6 bits each
Definition at line 76 of file quantization.h.
The documentation for this struct was generated from the following file:
