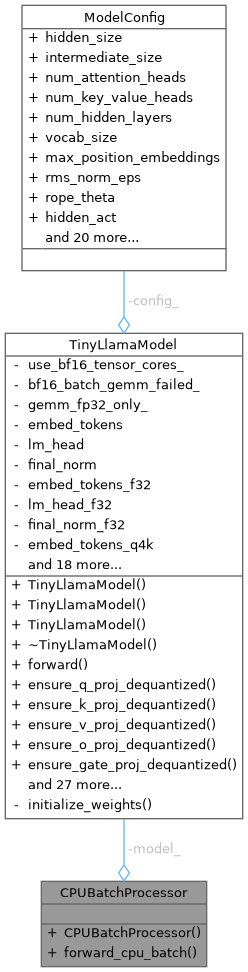
17 {
18
20 Logger::error(
"[CPU_BATCH_FWD] Input size mismatch. Expected: " +
23 return {};
24 }
25
31 Logger::error(
"[CPU_BATCH_FWD] Error: num_attention_heads is zero.");
32 return {};
33 }
39
41
44
50 Logger::error(
"[CPU_BATCH_FWD] Token offset exceeded num_tokens_in_batch");
51 return {};
52 }
56 }
57 }
58 } else {
62 }
63 }
64
73
75
78 lw.input_layernorm_f32.empty()
80 :
lw.input_layernorm_f32;
82
84
88
89 if (!
lw.q_proj_f32.empty()) {
91 }
else if (!
lw.q_proj_q8_0.empty()) {
93 }
else if (!
lw.q_proj_q6k.empty()) {
95 }
else if (!
lw.q_proj_q4k.empty()) {
97 } else {
98 Logger::error(
"[CPU_BATCH_FWD] Layer " + std::to_string(
l) +
": No Q proj weights found for CPU");
99 return {};
100 }
101
102 if (!
lw.k_proj_f32.empty()) {
104 }
else if (!
lw.k_proj_q8_0.empty()) {
106 }
else if (!
lw.k_proj_q6k.empty()) {
108 }
else if (!
lw.k_proj_q4k.empty()) {
110 } else {
111 Logger::error(
"[CPU_BATCH_FWD] Layer " + std::to_string(
l) +
": No K proj weights found for CPU");
112 return {};
113 }
114
115 if (!
lw.v_proj_f32.empty()) {
117 }
else if (!
lw.v_proj_q8_0.empty()) {
119 }
else if (!
lw.v_proj_q6k.empty()) {
121 }
else if (!
lw.v_proj_q4k.empty()) {
123 } else {
124 Logger::error(
"[CPU_BATCH_FWD] Layer " + std::to_string(
l) +
": No V proj weights found for CPU");
125 return {};
126 }
127
132
135 ", pos=" + std::to_string(
current_token_pos) +
") is out of range. Skipping RoPE.");
136 continue;
137 }
138
141
148
151
154 }
155 } else {
158 }
159
164 } else {
167 }
168 }
169
171
178 } else {
182 }
185 " is out of bounds for KV Cache access during attention. KVCache layers size: " +
186 std::to_string(
kv_cache->layers.size()) +
187 ". Filling attention output with zeros.");
189 } else {
190 Logger::error(
"[CPU_BATCH_FWD] KV Cache is null, cannot perform attention for layer " + std::to_string(
l) +
191 ". Filling attention output with zeros.");
193 }
194
196 if(!
lw.o_proj_f32.empty()) {
198 }
else if (!
lw.o_proj_q8_0.empty()) {
200 }
else if (!
lw.o_proj_q6k.empty()) {
202 }
else if (!
lw.o_proj_q4k.empty()) {
204 } else {
205 Logger::error(
"[CPU_BATCH_FWD] Layer " + std::to_string(
l) +
": No O proj weights found for CPU");
206 return {};
207 }
208
211 }
212
216 lw.post_attention_layernorm_f32.empty()
218 :
lw.post_attention_layernorm_f32;
219
221
224
225 #pragma omp parallel for schedule(static)
229 lw.moe_up_exps_f32.data(),
lw.moe_down_exps_f32.data(),
231 } else {
234
235 if (!
lw.gate_proj_f32.empty()) {
237 }
else if (!
lw.gate_proj_q8_0.empty()) {
239 }
else if (!
lw.gate_proj_q6k.empty()) {
241 }
else if (!
lw.gate_proj_q4k.empty()) {
243 } else {
244 Logger::error(
"[CPU_BATCH_FWD] Layer " + std::to_string(
l) +
": No gate_proj weights found for CPU");
245 return {};
246 }
247
248 if (!
lw.up_proj_f32.empty()) {
250 }
else if (!
lw.up_proj_q8_0.empty()) {
252 }
else if (!
lw.up_proj_q6k.empty()) {
254 }
else if (!
lw.up_proj_q4k.empty()) {
256 } else {
257 Logger::error(
"[CPU_BATCH_FWD] Layer " + std::to_string(
l) +
": No up_proj weights found for CPU");
258 return {};
259 }
260
266 }
267
268 if (!
lw.down_proj_f32.empty()) {
270 }
else if (!
lw.down_proj_q8_0.empty()) {
272 }
else if (!
lw.down_proj_q6k.empty()) {
274 }
else if (!
lw.down_proj_q4k.empty()) {
276 } else {
277 Logger::error(
"[CPU_BATCH_FWD] Layer " + std::to_string(
l) +
": No down_proj weights found for CPU");
278 return {};
279 }
280 }
281
284 }
285 }
286
289 }
291}
static void warning(const std::string &message)
static void error(const std::string &message)
void ensure_up_proj_dequantized(int layer_idx)
void ensure_v_proj_dequantized(int layer_idx)
std::vector< std::pair< float, float > > precomputed_freqs_cis_
std::vector< LayerWeights > layers
void ensure_o_proj_dequantized(int layer_idx)
void ensure_k_proj_dequantized(int layer_idx)
void ensure_q_proj_dequantized(int layer_idx)
void ensure_down_proj_dequantized(int layer_idx)
void ensure_gate_proj_dequantized(int layer_idx)
void attention_batch_cpu_sequence_aware(const std::vector< float > &q_batch_roped, KVCacheLayer ¤t_layer_kv_cache, std::vector< float > &batch_attn_output, int num_tokens_in_batch, const std::vector< int > &sequence_indices, const std::vector< int > &position_in_sequence, int num_q_heads, int num_kv_heads, int head_dim, float attention_scale, int max_seq_len_per_sequence)
void attention_batch_cpu(const std::vector< float > &q_batch_roped, KVCacheLayer ¤t_layer_kv_cache, std::vector< float > &batch_attn_output, int num_tokens_in_batch, int start_pos_in_sequence, int num_q_heads, int num_kv_heads, int head_dim, float attention_scale, float softcap)
void update_kv_cache_batch_cpu_sequence_aware(KVCache *kv_cache, int layer_idx, const std::vector< float > &k_batch_for_layer, const std::vector< float > &v_batch_for_layer, int num_tokens_in_batch, const std::vector< int > &sequence_indices, const std::vector< int > &position_in_sequence, int num_kv_heads, int head_dim)
void update_kv_cache_batch_cpu(KVCache *kv_cache, int layer_idx, const std::vector< float > &k_batch_for_layer, const std::vector< float > &v_batch_for_layer, int num_tokens_in_batch, int start_pos_in_sequence, int num_kv_heads, int head_dim)
int max_position_embeddings
void apply_rope_vector(std::vector< float > &x, int num_heads, int head_dim, int current_token_pos, const std::vector< std::pair< float, float > > &all_freqs_cis, int max_pos_embeddings, bool use_adjacent_pairing)
void matmul_q4k_f32_batch_cpu(const std::vector< block_q4_K > &mat_q4k, const std::vector< float > &batch_input_activations, std::vector< float > &batch_output_activations, int num_tokens, int output_dim, int input_dim)
std::vector< float > bf16vec_to_float_vec(const std::vector< uint16_t > &v_bf16)
void matmul_q8_0_f32_batch_cpu(const std::vector< block_q8_0 > &mat_q8_0, const std::vector< float > &batch_input_activations, std::vector< float > &batch_output_activations, int num_tokens, int output_dim, int input_dim)
void apply_rope_batch_cpu(std::vector< float > &q_batch, std::vector< float > &k_batch, int num_tokens, int num_q_heads, int num_kv_heads, int head_dim, int start_pos_in_sequence, const std::vector< std::pair< float, float > > &all_freqs_cis, int max_pos_embeddings, bool use_adjacent_pairing)
void matmul_f32_f32_batch_cpu(const std::vector< float > &mat_weights, const std::vector< float > &batch_input_activations, std::vector< float > &batch_output_activations, int num_tokens, int output_dim, int input_dim)
void matmul_q6k_f32_batch_cpu(const std::vector< block_q6_K > &mat_q6k, const std::vector< float > &batch_input_activations, std::vector< float > &batch_output_activations, int num_tokens, int output_dim, int input_dim)
void moe_ffn_f32_cpu(const float *x, int d, int d_ff, int E, int k, const float *router, const float *gate_exps, const float *up_exps, const float *down_exps, float *out, bool renorm)
void rmsnorm_batch_cpu(const std::vector< float > &x_batch, const std::vector< float > &weight, std::vector< float > &out_batch, int num_tokens, int hidden_size, float eps)